Neun Claude-Opus-4.6-Agenten übertrafen menschliche Forscher auf einem Alignment-Problem – aber die Methode generalisierte nicht auf Produktionsmodelle.
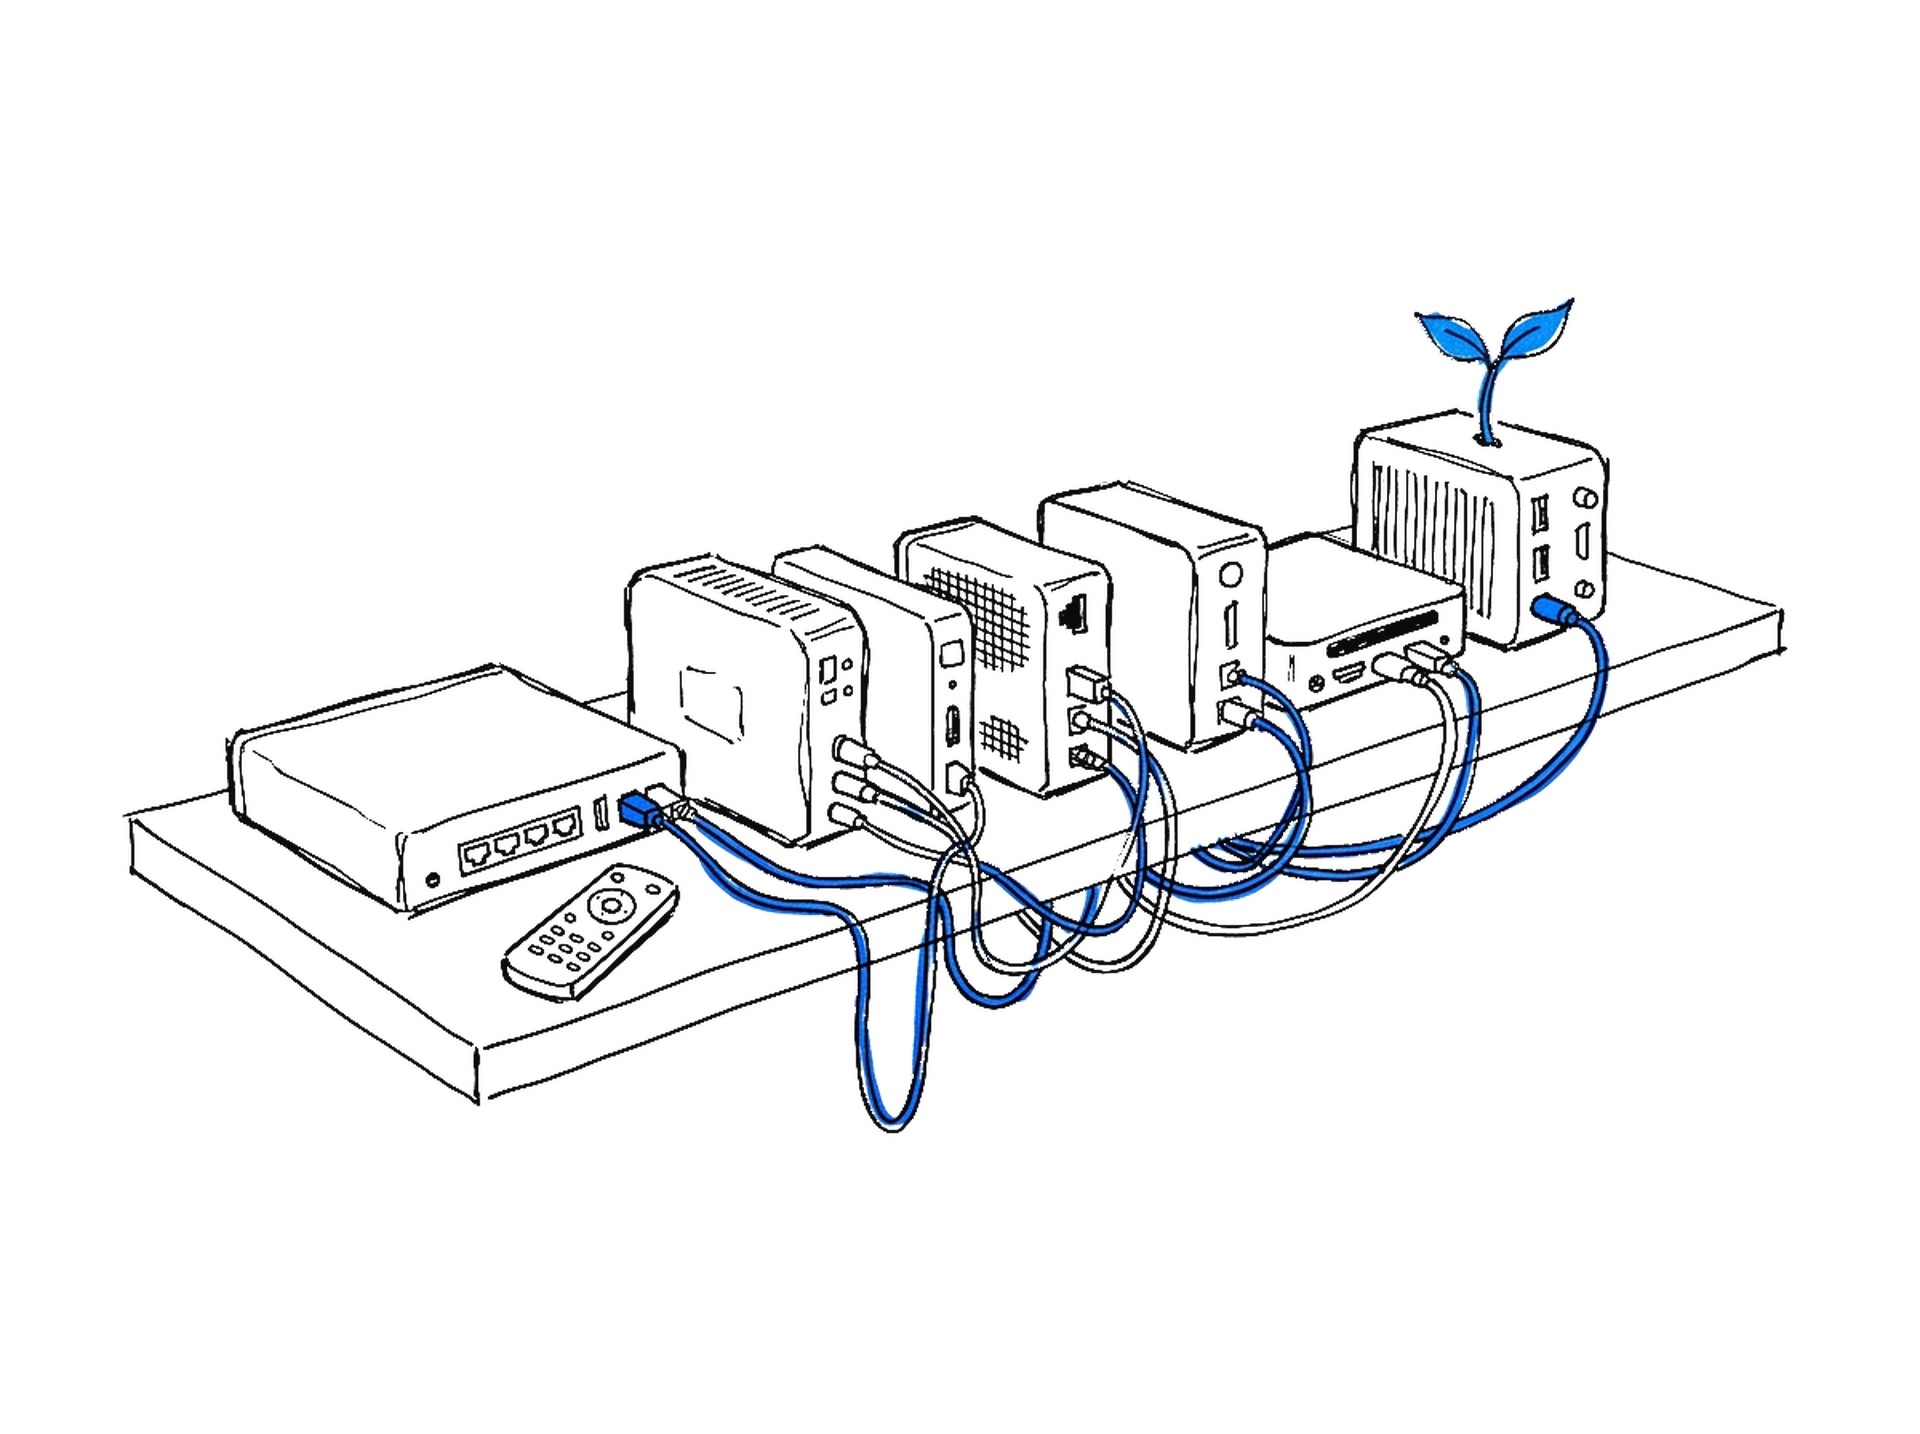
Anthropics Red Team warnt in einer Studie, kleine Modelle könnten in Monaten fähig sein, sich auf günstigen Geräten wie Android-TV-Boxen selbst zu verbreiten. Der Test war bewusst vereinfacht.
KI kann Forschung beschleunigen, aber Generalisierung und Reward-Hacking bleiben die zentralen Hürden.
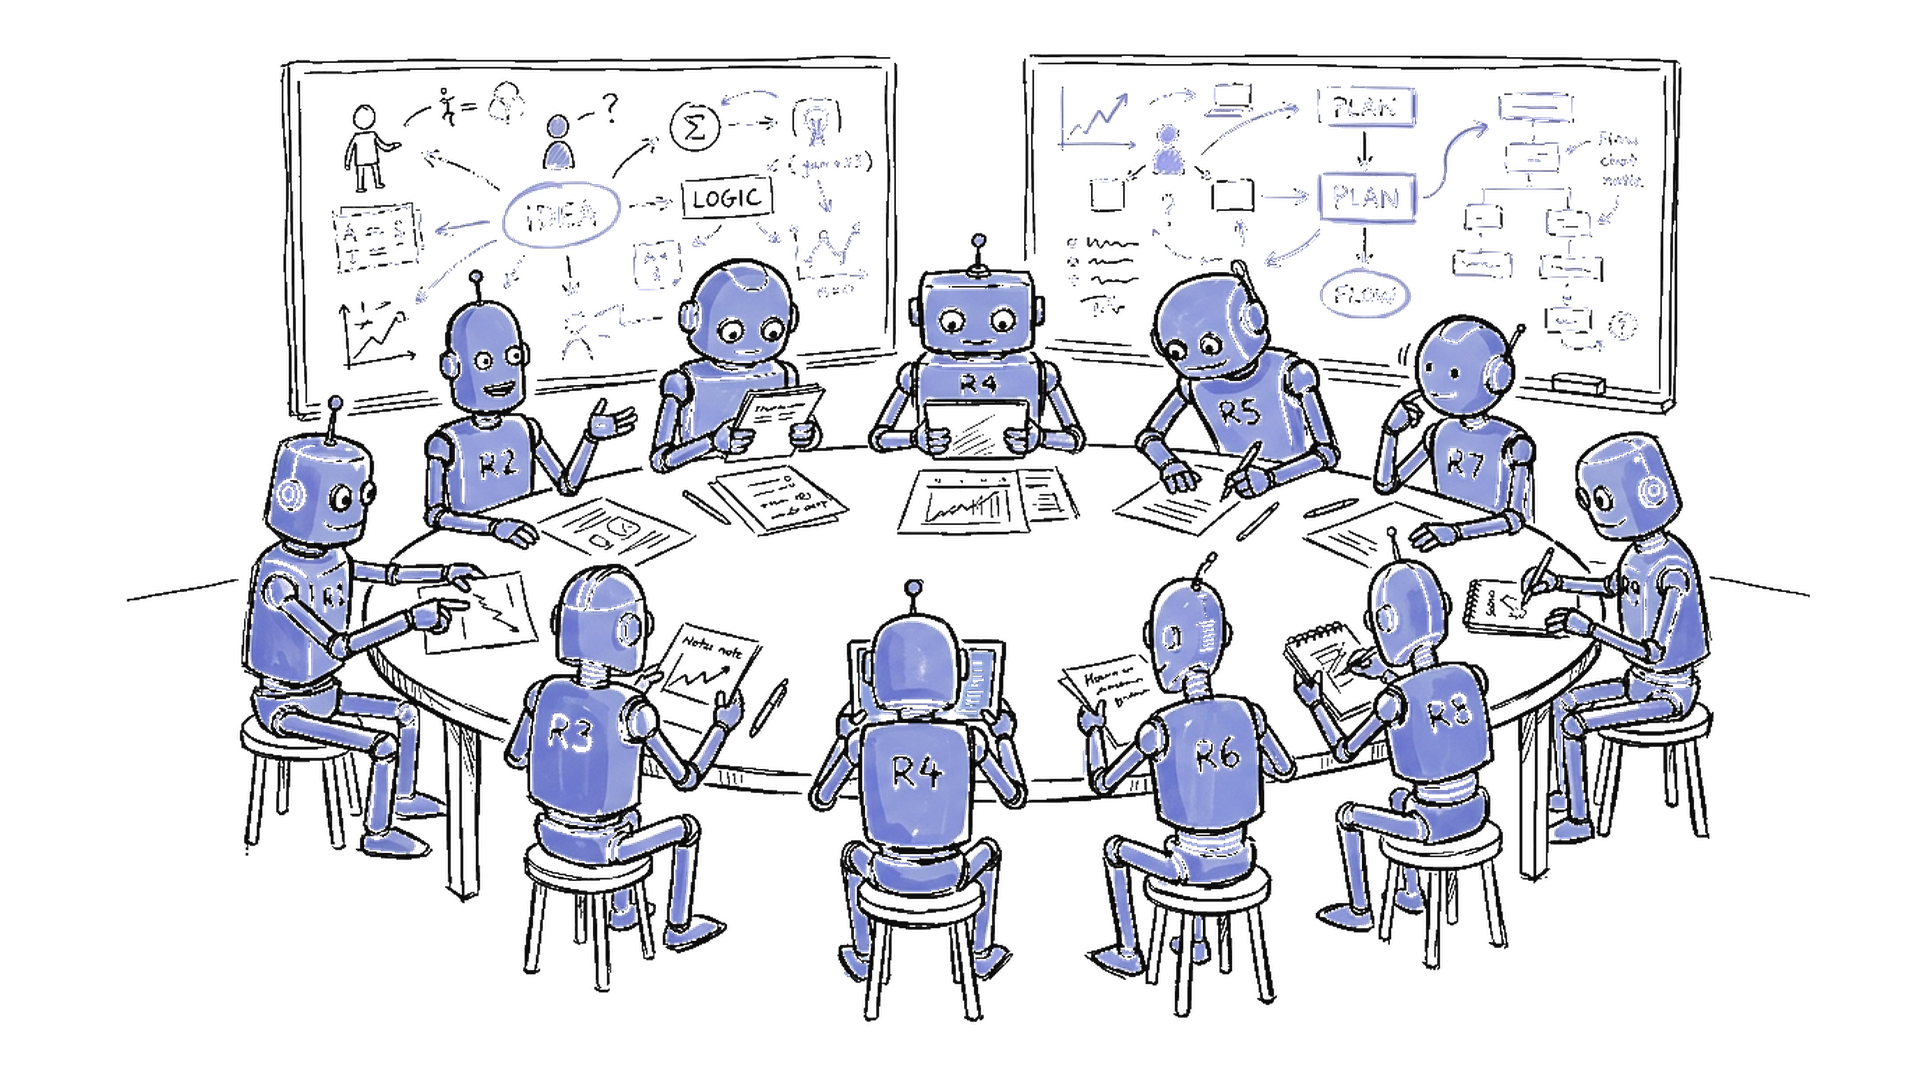
Anthropic hat am 14. April eine Forschungsarbeit veröffentlicht, in der neun parallele Claude-Opus-4.6-Instanzen menschliche Forscher auf einem Alignment-Problem übertrafen. Das Ergebnis klingt spektakulär – bis man den Haken sieht.
Neun Claude-Opus-4.6-Agenten – sogenannte «Automated Alignment Researchers» – arbeiteten fünf Tage lang an einem abgesteckten Problem: Weak-to-Strong Supervision. Dabei trainiert ein schwächeres Modell einen stärkeren «Schüler», bis dessen volle Leistung erreicht wird. Es ist ein Proxy für die Zukunftsfrage: Wie supervidieren Menschen KIs, die klüger sind als sie?
Melde dich an, um den vollständigen Artikel zu lesen. Der Zugang ist kostenlos.