GPT-6 Astra knackt Enigma-Funkspruch von 1941 – in zwei Tagen
OpenAIs GPT-6 Astra hat einen deutschen Heeres-Funkspruch vom 10. Juli 1941 entschlüsselt, der seit 2005 als ungelöst galt. Das Modell suchte sich das Ziel selbst aus und schrieb Enigma-Simulator und Enigma-Bombe eigenständig in Python und C++. Dieselbe Autonomie ist der Grund, weshalb OpenAI seine leistungsfähigsten Modelle gerade gestoppt hat.

Pascal Eugster
GRÜNDER & ENTWICKLER
27. SEPTEMBER 2026
3 MIN. LESEZEIT
INHALT
INHALT
in
PARTNER · INOO GMBH
Wie viel KI verträgt dein Betrieb? In 30 Minuten Klartext.
Kostenloses Erstgespräch — herstellerneutral, direkt aus dem Rheintal.
Gespräch buchen →
DAS WICHTIGSTE IN KÜRZE
Nicht die Kryptografie ist neu, sondern dass ein Modell Ziel, Hypothese, Werkzeugbau und Archivrecherche ohne menschliche Zwischenschritte erledigt.
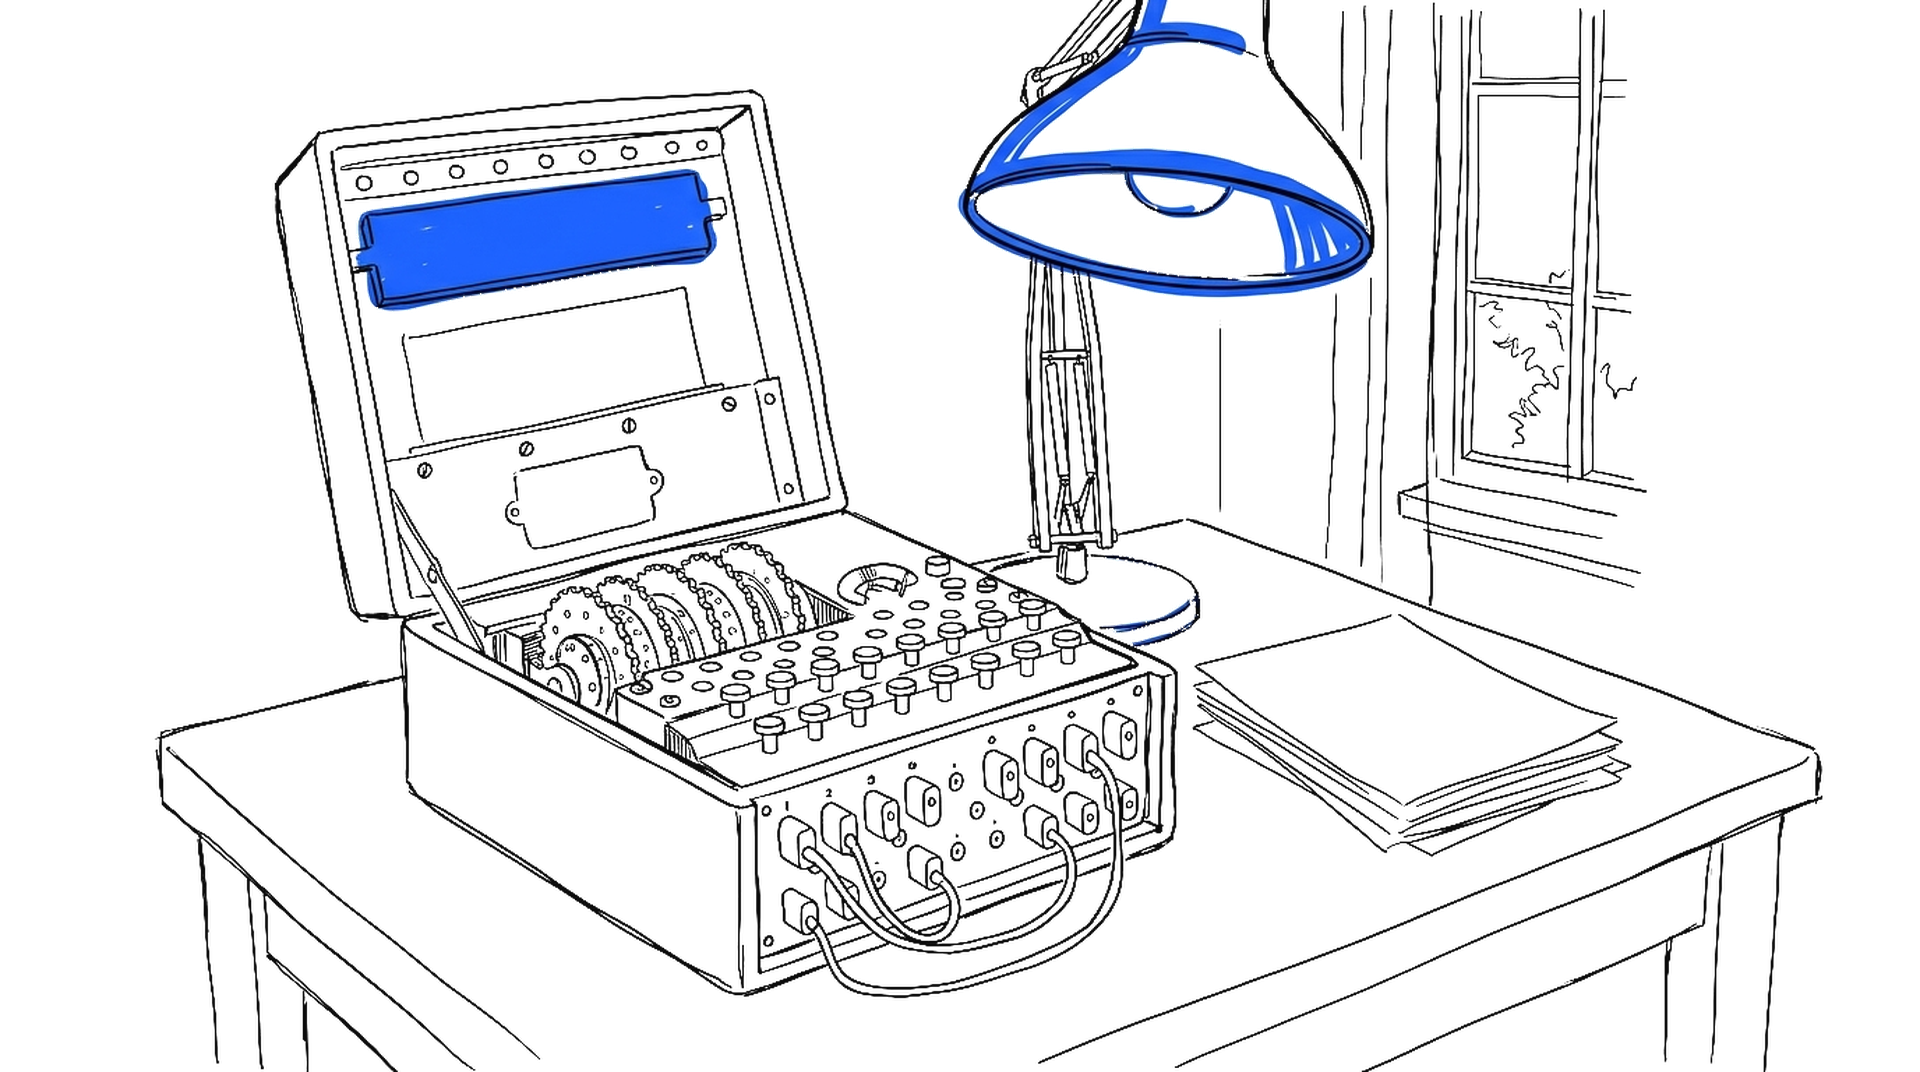
OpenAIs GPT-6 Astra hat einen deutschen Heeres-Funkspruch vom 10. Juli 1941 entschlüsselt, der seit seiner Veröffentlichung im Netz 2005 allen Lösungsversuchen widerstanden hatte. Das Modell brauchte rund zwei Tage und schrieb sich das Werkzeug selbst: einen Enigma-Simulator und eine Enigma-Bombe in Python und C++. Validiert hat den Bruch der Kryptologe Frode Weierud, der den Bestand ungelöster Wehrmachts-Funksprüche in seinem Archiv Crypto Cellar Research führt.
82 Buchstaben, 21 Jahre ungelöst
Die Nachricht trägt die Kennung MVUEH und landete am 10. Juli 1941 um 17:30 bei der Funkstelle des SS-Totenkopf-Quartiermeisters, wo sie als Nr. 172 ins Eingangsbuch kam. Ihr Klartext, editorisch geglättet, ist von entwaffnender Banalität: «Bitte um Angabe des Marschweges. Befinde mich in Rosenow, Rosenow. Sofort Funkantwort.» Darunter eine Signatur, vorläufig als Waschbusch gelesen – 82 Buchstaben, ein Logistik-Anruf mitten im Ostfeldzug.
Dass daran 21 Jahre lang alle scheiterten, hatte laut Weierud zwei Gründe: Fehler in der Abschrift des Chiffrats – und einen Übertrag der linken Walze beim 72. Buchstaben, ein seltener Fall, der jeden Angriff erschwert.
Rosenow, Rosenow als Einbruchstelle
Bemerkenswert ist nicht die Kryptografie, sondern die Arbeitsweise. Entwickler Carter Leffen gab Astra nur den allgemeinen Auftrag, sich an den ungelösten Sprüchen der Crypto-Cellar-Seite zu versuchen. Das Modell wählte MVUEH selbst als vielversprechendstes Ziel und setzte auf den doppelt vorkommenden Ortsnamen «Rosenow Rosenow» als Crib – eine geratene Klartextstelle, an der ein Angriff ansetzen kann. Ohne solche Einschränkung hat die Standard-Enigma rund 159 Trillionen mögliche Tageseinstellungen.