Google lässt Gemini prüfen, ohne die Fragen zu sehen
DeepMind liess Gemini 2.5 Flash Lite erstmals doppelblind prüfen: Die Prüfer sahen die Modellgewichte nicht, Google die Testfragen nicht. Ein Fortschritt – mit offensichtlichem Interessenkonflikt.

Pascal Eugster
GRÜNDER & ENTWICKLER
28. AUGUST 2026
4 MIN. LESEZEIT
INHALT
INHALT


Präsentiert & entwickelt von
kinewsletter.ch ist ein Projekt der Inoo GmbH
KI-Beratung und Softwareentwicklung aus dem St. Galler Rheintal.
inoo.ch
DAS WICHTIGSTE IN KÜRZE
Das Verfahren löst ein reales Problem, wird aber von der Partei ausgerichtet, die davon profitiert. Für Schweizer Firmen zählt die praktische Lehre: eigenes, geheimes Testset statt Leaderboard.
Google DeepMind hat am 27. August einen Pilotversuch vorgestellt, den das Unternehmen als weltweit erste doppelblinde Evaluation eines kommerziellen KI-Modells bezeichnet: Externe Prüfer testeten Gemini 2.5 Flash Lite in einer hardware-verschlüsselten Rechenkammer – sie bekamen die Modellgewichte nie zu sehen, und Google bekam die geheimen Testfragen nie zu sehen. Beteiligt waren das Singapore AI Safety Institute, die Organisationen OpenMined und AVERI sowie das Benchmark-Konsortium MLCommons. Es geht um ein Problem, das jede Modell-Rangliste betrifft, die du liest.
Wenn der Prüfling die Prüfung schon kennt
Benchmarks sind Prüfungen für KI-Modelle. Und wie bei jeder Prüfung ist die Note wertlos, wenn der Kandidat die Fragen vorher gesehen hat. Fachleute nennen das Benchmark-Contamination: Testfragen landen – absichtlich oder versehentlich – in den Trainingsdaten.
Das ist keine Theorie. Eine von Google selbst zitierte Untersuchung fand bei rund der Hälfte von 31 geprüften Modellen Hinweise auf durchgesickerte Benchmark-Daten; eine Nachfolgestudie von 2026 zeigt, dass die Verzerrung mit der Modellgrösse wächst. Und das Paper «The Leaderboard Illusion» dokumentierte, wie ein Frontier-Labor 27 private Modellvarianten auf der Vergleichsplattform Chatbot Arena testete – und danach nur die beste veröffentlichte.
Der Haken bei geschlossenen Modellen: Wer sie prüfen will, muss seine Fragen durch die API des Anbieters schicken. Damit sieht der Anbieter sie im Klartext. Die Alternative wäre, dass er seine Gewichte herausgibt – was laut dem technischen Bericht zu diesem Zweck noch nie ein externer Prüfer im Klartext erhalten hat.
Zwei Tresore in einer Kiste
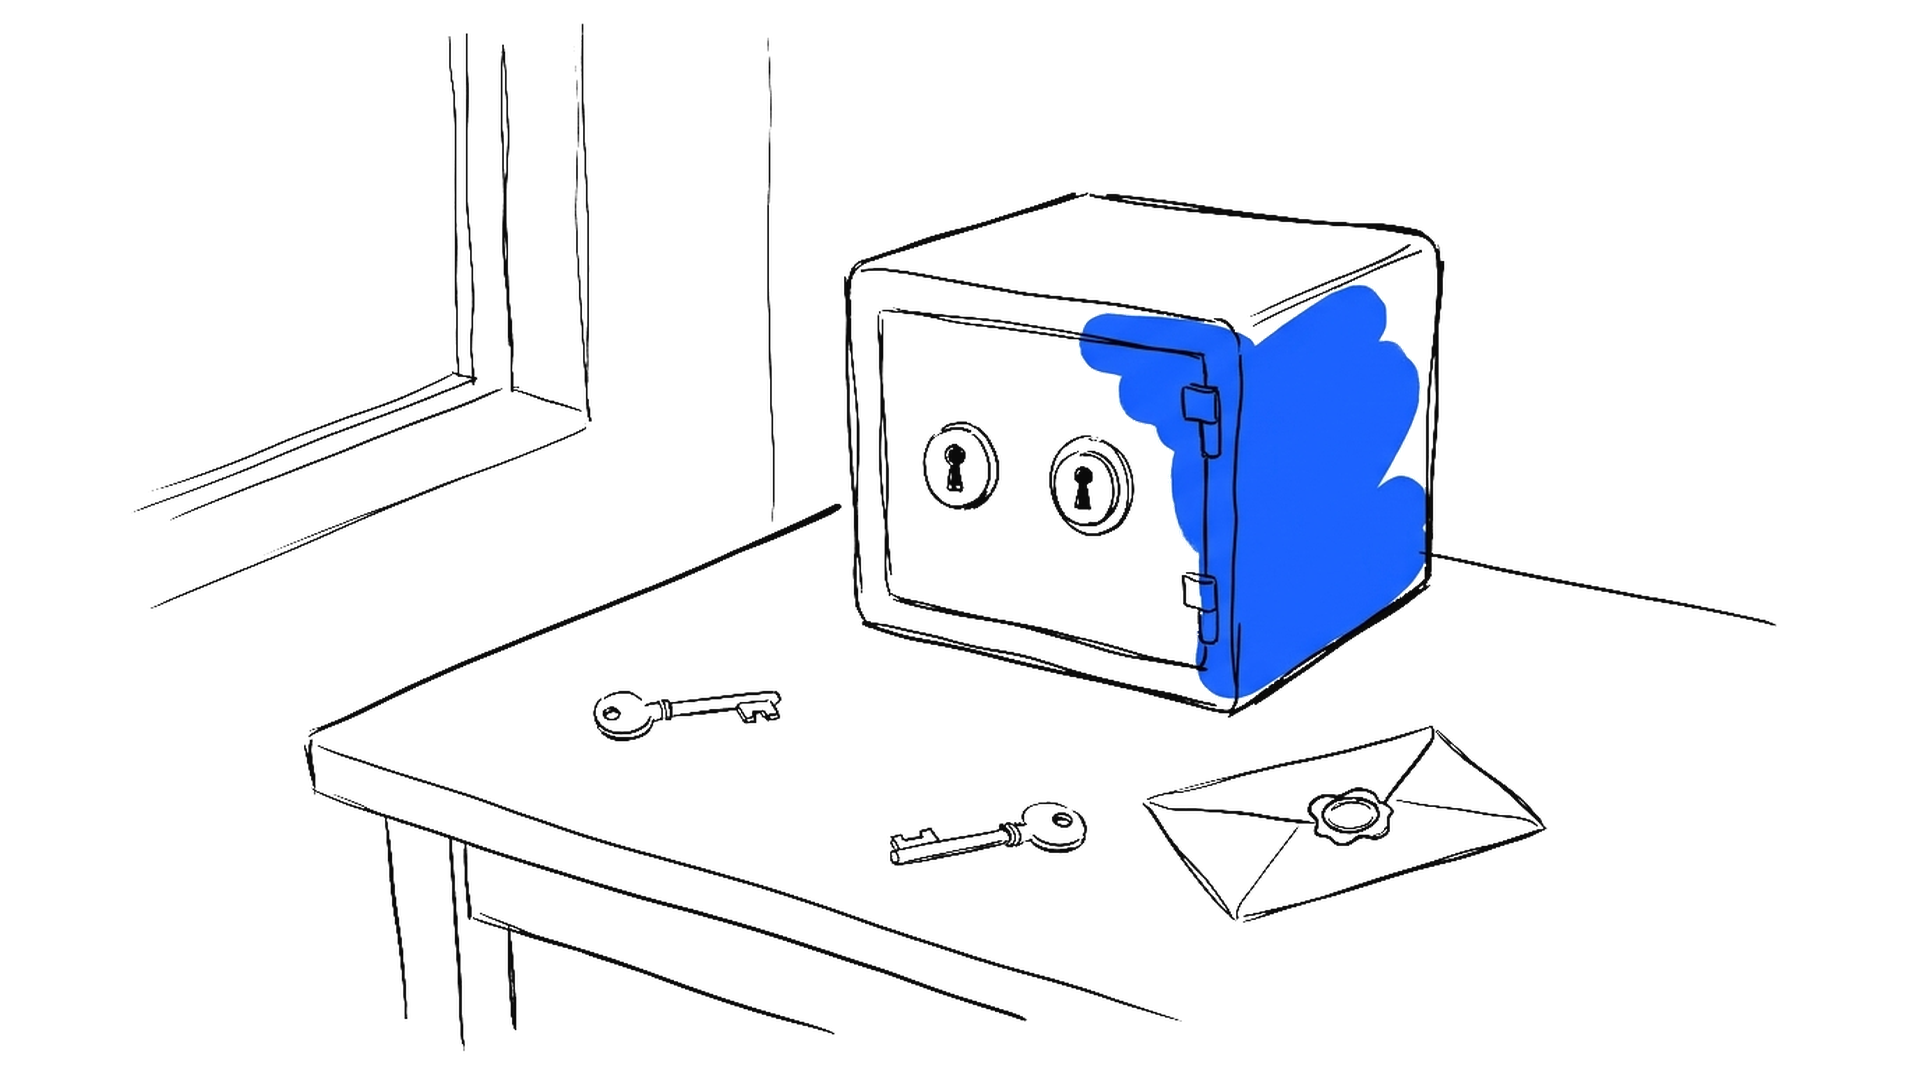
Das neue Verfahren löst den Konflikt mit Hardware statt mit Verträgen. Die Modellgewichte fliessen verschlüsselt in den Speicher einer NVIDIA-H100-Grafikkarte, die Testfragen in den per Intel-Technik verschlüsselten Arbeitsspeicher desselben Rechners. Beide Seiten prüfen vorher kryptografisch nach, welche Software dort läuft, und müssen den Code der jeweils anderen freigeben. Nach dem Lauf gehen nur zusammengefasste Ergebnisse hinaus, die Kammer wird gelöscht.
Der Rechenaufwand dafür liegt laut Bericht bei unter 5 Prozent. Der eigentliche Engpass sei ein anderer, schreiben die Autoren: Juristische Vereinbarungen und gegenseitige Code-Reviews zwischen den Organisationen.
Ein kleines Modell, keine einzige Zahl
Hier lohnt der genaue Blick. Geprüft wurde Gemini 2.5 Flash Lite – ein kleines, günstiges Modell einer älteren Generation, nicht Googles aktuelles Spitzenprodukt. Und veröffentlicht wurde kein einziger Punktwert. Der Pilot zeigt, wie getestet wurde, nicht wie gut Gemini abschnitt.
Auch der Superlativ verdient eine Fussnote. Im Blogpost heisst es «weltweit erste», im technischen Bericht deutlich vorsichtiger «nach unserem besten Wissen». Denn 2024 hatte OpenMined dieselbe Technik bereits mit dem britischen AI Safety Institute und Anthropic erprobt – damals nur mit GPT-2 und einer Fünf-Zeilen-Stichprobe. Neu ist der Umfang und die gegenseitige Geheimhaltung, nicht die Idee.
Google prüft, hostet und signiert
Der Interessenkonflikt liegt offen: Google stellt das Modell, die Cloud und den Blogpost. Bemerkenswert ist, dass der technische Bericht ihn selbst einräumt. Nicht der gesamte Gemini-Code liess sich offenlegen – AVERI wurde informiert und akzeptierte den Aufbau trotzdem. Die einzelnen Software-Builds sind nicht unabhängig nachbaubar. Und wörtlich, hier übersetzt:
Wir verlassen uns auf Googles Dienste, um den Attestierungsbericht zu signieren und zu verifizieren, was Google in den Verifikationspfad stellt und damit das nötige Vertrauen in Google erhöht.
Das Verfahren reduziert also, wie viel man Google glauben muss. Es schafft das Vertrauen nicht ab, sondern verschiebt es auf Hardware-Hersteller und Cloud-Betreiber.
Warum offene Modelle das Problem gar nicht haben
Für dich ist die praktische Lehre wichtiger als die Kryptografie. Der Bericht hält selbst fest, dass die ganze Übung bei Modellen mit offenen Gewichten entfällt: herunterladen, auf eigener Infrastruktur testen, fertig. Genau so funktioniert Apertus, das Modell von ETH Zürich, EPFL und dem CSCS – Gewichte, Trainingsdaten und Code sind öffentlich.
Wählst du in einem Schweizer Unternehmen ein Modell aus, gilt dieselbe Konsequenz wie bei Optima vor elf Tagen und bei Inherents Faraday vor vier: Bau dir ein eigenes Testset aus echten Aufgaben deines Betriebs, halte es unter Verschluss und veröffentliche es nie. Eine öffentliche Rangliste sagt dir, wer gut Prüfungen schreibt. Deine eigenen Fälle sagen dir, wer deine Arbeit erledigt.
Quellen
Piloting the world's first double-blind AI evaluations (Google DeepMind)↗ EXTERNER LINKDouble-blind evaluations – Technical Report (Google DeepMind)↗ EXTERNER LINKDouble-blind reliability evaluation (MLCommons)↗ EXTERNER LINKGoogle's double-blind evaluation (The New Stack)↗ EXTERNER LINKSecure enclaves for AI evaluation (OpenMined)↗ EXTERNER LINKThe Leaderboard Illusion (arXiv)↗ EXTERNER LINKBenchmarking Benchmark Leakage (arXiv)↗ EXTERNER LINKConfidential Computing (Google Cloud)↗ EXTERNER LINKSwiss AI Initiative↗ EXTERNER LINKFIRMEN IN DIESEM ARTIKEL
WEITERLESENDas könnte dich auch interessieren.
KI-FORSCHUNG·3. OKTOBER 2026
arXiv erlaubt dir nur noch zwei Paper pro Monat
Die wichtigste Preprint-Plattform der Wissenschaft führt ein Einreichungslimit ein: zwei Paper pro Person und Monat. Grund ist die KI-getriebene Flut, die freiwillige Moderatoren überlastet.
KI-FORSCHUNG·2. OKTOBER 2026
DeepMind markiert KI-Proteine: 100 % Detektion, Funktion bleibt
Google DeepMind hat in Nature SynthID Bio vorgestellt, ein Wasserzeichen für KI-designte Proteine. Laut Paper erkennt es Sequenzen mit 100 % Trefferquote bei 0,1 % Fehlalarm, ohne die Funktion zu stören. Entfernbar ist es aber trotzdem.
KI-FORSCHUNG·2. OKTOBER 2026
Roboter können 74 % der körperlichen Aufgaben, rentabel sind 0.3 %
Anthropic hat gemessen, welche körperlichen Aufgaben Roboter heute übernehmen könnten: 74 %, das sind 34 % der Arbeitszeit. Kostengünstiger als Menschen sind sie aber nur bei 0.3 %. Bei heutigen Preistrends dauert es rund 40 Jahre bis 10 %.
KI-FORSCHUNG·29. SEPTEMBER 2026
22 KI-Forschende warnen vor einer «Intelligenzexplosion»
Geoffrey Hinton, Yoshua Bengio und OpenAI-Forschungschef Jakub Pachocki warnen in einem Papier vor einer Intelligenzexplosion. Automatisierte KI-Forschung könnte Jahre an Fortschritt in Monate pressen, die Politik brauche Einblick. Kritiker sehen auch Eigeninteresse der Labors.
KI-FORSCHUNG·28. SEPTEMBER 2026
Stanford steckt GPT-6 Astra direkt in einen Haushaltsroboter
Forschende aus Stanford und Caltech streichen bei ihrem Roboter die gelernte Steuerungsschicht und lassen ein Sprachmodell direkt die Bewegungsbefehle aussuchen. Was das taugt – und was die Demo verschweigt.
KI-FORSCHUNG·27. SEPTEMBER 2026
GPT-6 Astra knackt Enigma-Funkspruch von 1941 – in zwei Tagen
OpenAIs GPT-6 Astra hat einen deutschen Heeres-Funkspruch vom 10. Juli 1941 entschlüsselt, der seit 2005 als ungelöst galt. Das Modell suchte sich das Ziel selbst aus und schrieb Enigma-Simulator und Enigma-Bombe eigenständig in Python und C++. Dieselbe Autonomie ist der Grund, weshalb OpenAI seine leistungsfähigsten Modelle gerade gestoppt hat.